计算理论
参考《形式语言与自动机》,yn计算理论特化
有穷自动机
DFA
最小DFA
标记可区分状态,如果对于某个输入符号 \(a\),\([\,\delta(q,a),\,\delta(r,a)\,]\) 被标记了,那么将 \([q, r]\) 也进行标记,倒着
- 标记所有[\(f\), \(state\)],其中 \(f\) 是终态,\(state\) 是所有非中止状态
- 按个枚举每个输入字母a,看是否有两个状态 \(q, r\) 满足 \(\delta(q, a) = \delta(r, a)\),如果有,则将 \([q, r]\) 标记
- 反复第二步直到没有新的状态被标记
- 将所有未被标记的状态合并为一个状态,即为最小DFA
- 删掉合并后不可达的状态
NFA
- DFA与NFA等等价性
- NFA \(\rightarrow\) DFA
- 构造DFA的子集构造法
- NFA \(\rightarrow\) DFA
NFA-ε
- NFA-ε与NFA的区别
- NFA-ε允许空转移(\(\delta(q, \epsilon) = \{p\}\))
- NFA-ε与NFA的等价性
- NFA-ε \(\rightarrow\) NFA
- 构造NFA的ε-闭包
- 对于每个转移函数,其转移的状态是其ε-闭包转移的状态
- 转移函数的定义:\(\delta_N(q, a) = \bigcup_{p \in CL(q)} \delta_E(p, a)\)
- 终态的定义:\(F' = \{ q \in Q \mid CL(q) \cap F \neq \emptyset \}\)
- 构造NFA的ε-闭包
- NFA-ε \(\rightarrow\) NFA
正则表达式
DFA = NFA = NFA-ε = 正则表达式
等价性证明
- 正则表达式 \(\rightarrow\) NFA-ε
- 分别使用NFA-ε构造三种基本正则表达式
- 连接、并、星闭包
DFA \(\rightarrow\) 正则表达式
\[R_{ij}^{k} = R_{ij}^{k-1} + R_{ik}^{k-1}(R_{kk}^{k-1})^{*}R_{kj}^{k-1}\]
正则语言的泵引理
正则语言的泵引理 对于任意正则语言 \(L\),存在一个常数 \(n\)(称为泵引理常数),使得对于 \(L\) 中任意长度大于等于 \(n\) 的字符串 \(w\),都可以将 \(w\) 分解为 \(w = xyz\),满足:
- \[\vert xy\vert \leq n\]
- \[\vert y\vert > 0\]
- 对任意 \(i \geq 0\),\(xy^iz \in L\)
这个性质常用于证明某些语言不是正则语言(通过反证法)
正则语言的闭包性质/判定性质
闭包性质
任何在差集下封闭的语言,在交集下也封闭 \(\Rightarrow\) 交集不封闭则差集不封闭
几乎在所有操作下正则语言都是封闭的,包括:并、交、差、补、连接、星闭包等(考虑正则表达式的构造)
- 乘积自动机
- 通过两个DFA的状态对的笛卡尔积构造一个新的DFA
- 转移函数定义为 \(\delta((p_1, p_2), a) = (\delta_1(p_1, a), \delta_2(p_2, a))\)
- 构造不同的终止态
- 交集: \(F = F_1 \cap F_2\),即两个DFA的终态对都为终态
- 差集: \(F = F_1 \setminus F_2\),即第一个DFA为终态且第二个DFA非终态的状态对
- 并集: \(F = F_1 \cup F_2\),即只要有一个DFA为终态的状态对
- 等价性判定: 构造 \(L_1 \triangle L_2 = (L_1 \setminus L_2) \cup (L_2 \setminus L_1)\),判断其是否为空语言(即两个DFA等价)
判定性质
- 是否为空 终止状态可达就为空
- 是否有限 存在长度大于等于n,小于等于2n-1的字符串属于语言,则语言无限(状态数,鸽笼原理)
- 等价性判定使用乘积自动机
CFG
BNF表示法
- BNF编程语言使用的上下文无关文法
::=: 表示产生: \(\rightarrow\)<name>: 表示变量name|: 表示或: \(\vert\)...:表示一个或多个: \(a...\)= \(A\rightarrow Aa\vert a\)[...]:表示可选项: \([a] = A \rightarrow a\vert \epsilon\){...}: 表示一系列符号,使用一个变量进行替换
- example:
<statement_list> ::= <statement> [{;<statement>}...]L→SB,B→C∣ε,C→AC∣A,A→;S C表示A...
推导
最左推导与最右推导
顾名思义,强制每次使用最左/最右的变量进行替换
解析树
起始符号根节点,变量中间节点,终结符/\(\epsilon\)叶子节点
解释树的产出就是按照前序遍历的顺序,将每个叶子节点的值连接起来
最左(右)推导与解析树的等价性
- 根节点为A且产出w的解析树,则 \(A\Rightarrow^{*}_{lm}w\)
- 若 \(A\Rightarrow^{*}_{lm}w\),则一定存在一棵解析树,其根节点为A且产出w
- 1的证明:对树的高度进行归纳
- 基础情况:高度为1,根节点为A且产出 \(a_{1},a_{2}...a_{n}\),则一定有产生式\(A\rightarrow a_{1},a_{2}...a_{n}\),得最左推导\(A\Rightarrow^{*}_{lm}a_{1},a_{2}...a_{n}\)
- 归纳假设:假设对于高度小于k的树,结论成立
- 归纳步骤:对于高度为k的树,根节点为A且产出 \(a_{1},a_{2}...a_{n}\),则存在一个产生式 \(A\rightarrow B_{1}B_{2}...B_{m}\),其中 \(B_{i}\)为高度小于k的树的根节点,根据归纳假设,对于每个\(B_{i}\),都有 \(B_{i}\Rightarrow^{*}a_{i1},a_{i2}...a_{ij}\),因此 \(A\Rightarrow^{*}a_{1},a_{2}...a_{n}\)
- 2的证明:对推导长度进行归纳
- 基础情况:推导长度为1,则\(A\Rightarrow_{lm}a\),则一定存在一棵解析树,其根节点为A且产出a
- 归纳假设:假设对于推导长度小于k的推导,结论成立
- 归纳步骤:对于推导长度为k的推导,则存在一个产生式\(A\rightarrow B_{1}B_{2}...B_{m}\),其中\(B_{i}\)为高度小于k的树的根节点,根据归纳假设,对于每个\(B_{i}\),都有 \(B_{i}\Rightarrow^{*}_{lm}a_{i1},a_{i2}...a_{ij}\) 构成一个解析树,因此 \(A\Rightarrow^{*}_{lm}a_{1},a_{2}...a_{n}\) 就是将这些解析树的根节点连接起来的结果
Chomsky范式
- 去除无用变量
- 从能直接产生终结符的变量开始,进行广度优先遍历,将能到达的变量标记为有用变量,去除所有未被标记的变量有关的产生式
去除空串
需要注意去除掉空产生式后,语言中将不再包含空串,所以这里只考虑语言\(L-\{\epsilon\}\)
将每个产生式\(A \rightarrow X_{1}X_{2}...X_{n}\)转化为一系列产生式
\[S\rightarrow ABC \Rightarrow S \rightarrow ABC \mid AB \mid AC \mid BC \mid A \mid B \mid C\]- 先去除所有的空产生式,如果有变量被整个去除了,就去除所有和这个变量相关的产生式,重复
- 前后产生式语言等价性证明
去除单一变量(单元产生式) 指的是产生式体中只有一个变量的产生式,如\(A \rightarrow B\)
- 语法清洗
- 去除 \(\epsilon\)-产生式
- 去除单元产生式
- 去除无法推导出终结字符串的变量
- 去除从起始符号不可达的变量
- Chomsky范式
- 形式: \(A \rightarrow BC\) 或 \(A \rightarrow a\) 或 \(S \rightarrow \epsilon\)
- 其中\(A, B, C\)为变量,\(a\)为终结符
- 注意: \(S \rightarrow \epsilon\)只在语言包含空串时存在
PDA
定义
PDA(下推自动机)是一个七元组:
\[P = (Q, \Sigma, \Gamma, \delta, q_0, Z_0, F)\]
- \(Q\):状态的有限集合
- \(\Sigma\):输入符号的有限集合(输入字母表)
- \(\Gamma\):栈符号的有限集合(栈字母表)
- \(\delta\):转移函数,\(\delta: Q \times (\Sigma \cup \{\epsilon\}) \times \Gamma \rightarrow 2^{Q \times \Gamma^*}\),表示状态、输入符号和栈顶符号决定的转移
- \(q_0 \in Q\):初始状态
- \(Z_0 \in \Gamma\):初始栈符号
- \(F \subseteq Q\):终态的集合
PDA 通过状态、输入符号和栈顶符号决定转移,并可对栈进行推入/弹出操作
即时描述(Instrantaneous Description, ID)
即时描述是 PDA 在某一时刻的状态表示,通常表示为三元组 \((q, w, \alpha)\),其中:
- \(q \in Q\):当前状态
- \(w \in \Sigma^*\):未处理的输入串
- \(\alpha \in \Gamma^*\):栈中的符号串
定义转移关系:\(I \vdash J\),指ID \(I\) 可以通过 PDA 一步移动变成 ID \(J\)
语言的接受方式
- 接受状态:PDA 在某个终态 \(q_f \in F\) 时接受输入串
- 空栈接受:PDA 在输入串处理完毕且栈为空时接受输入串
这两者等价性的证明
QAQ
PDA(非确定性NPDA)与CFG的等价性
从CFG到NPDA的构造
- 对于每个产生式 \(A \rightarrow \alpha\),构造转移规则:
- \[(q, \alpha) \in \delta(q, \epsilon, A)\]
- 对于每个终结符 \(a\),构造转移规则:
- \[(q, \epsilon) \in \delta(q, a, a)\]
等价性证明:
- 对转移步数进行归纳
QAQ
从NPDA到CFG的构造
- 构造思路:G 中的变量都形如 \([pXq]\),这个变量产生且仅产生使得 \((p, w, X) \vdash^* (q, \epsilon, \epsilon)\) 的字符串 \(w\)。
- 构造方法:
- 对于 NPDA 的每对状态 \(p, q\) 和每个栈符号 \(X\),引入变量 \([pXq]\)。
- 对于每个转移 \(\delta(p, a, X) \ni (r, \gamma)\),其中 \(\gamma = Y_1Y_2...Y_k\),添加产生式:
- \([pXq] \rightarrow a [rY_1s_1][s_1Y_2s_2]...[s_{k-1}Y_ks_k]\),其中 \(s_1, ..., s_k\) 是任意状态(枚举),\(s_k = q\)。
- 若 \(\gamma = \epsilon\),则 \([pXq] \rightarrow a\)(\(q = r\))。
- 起始变量为 \([q_0Z_0q_f]\),\(q_0\) 为初态,\(Z_0\) 为初始栈符号,\(q_f\) 为终态。
为什么不考虑 \(p, X\) 无法转移到 \(q\) 状态的情况?
实际上,如果 \([pXq]\) 无法通过任何转移推导出字符串(即不存在从 \(p\) 状态、栈顶为 \(X\) 到 \(q\) 状态且栈为空的路径),那么 \([pXq]\) 在文法中就没有任何产生式,也就无法推导出任何字符串。这样的变量在最终生成的文法中是“无用变量”,不会影响文法生成的语言。因此,构造时可以对所有 \([pXq]\) 都引入变量,但只有存在有效路径时才会有对应产生式,无用变量可以在后续化简时去除。
- 等价性证明:对推导步数进行归纳
QAQ
CFL
CFL的泵引理
对于每一个上下文无关语言 \(L\),存在一个整数 \(n\),使得对于任意 \(z \in L\) 且 \(\vert z\vert \geq n\),都可以将 \(z\) 分解为 \(z = uvwxy\),满足:
- \[\vert vwx\vert \leq n\]
- \[\vert vx\vert > 0\]
- 对任意 \(i \geq 0\),\(uv^iwx^iy \in L\)
该性质常用于证明某些语言不是上下文无关语言(通过反证法)。
泵引理的证明
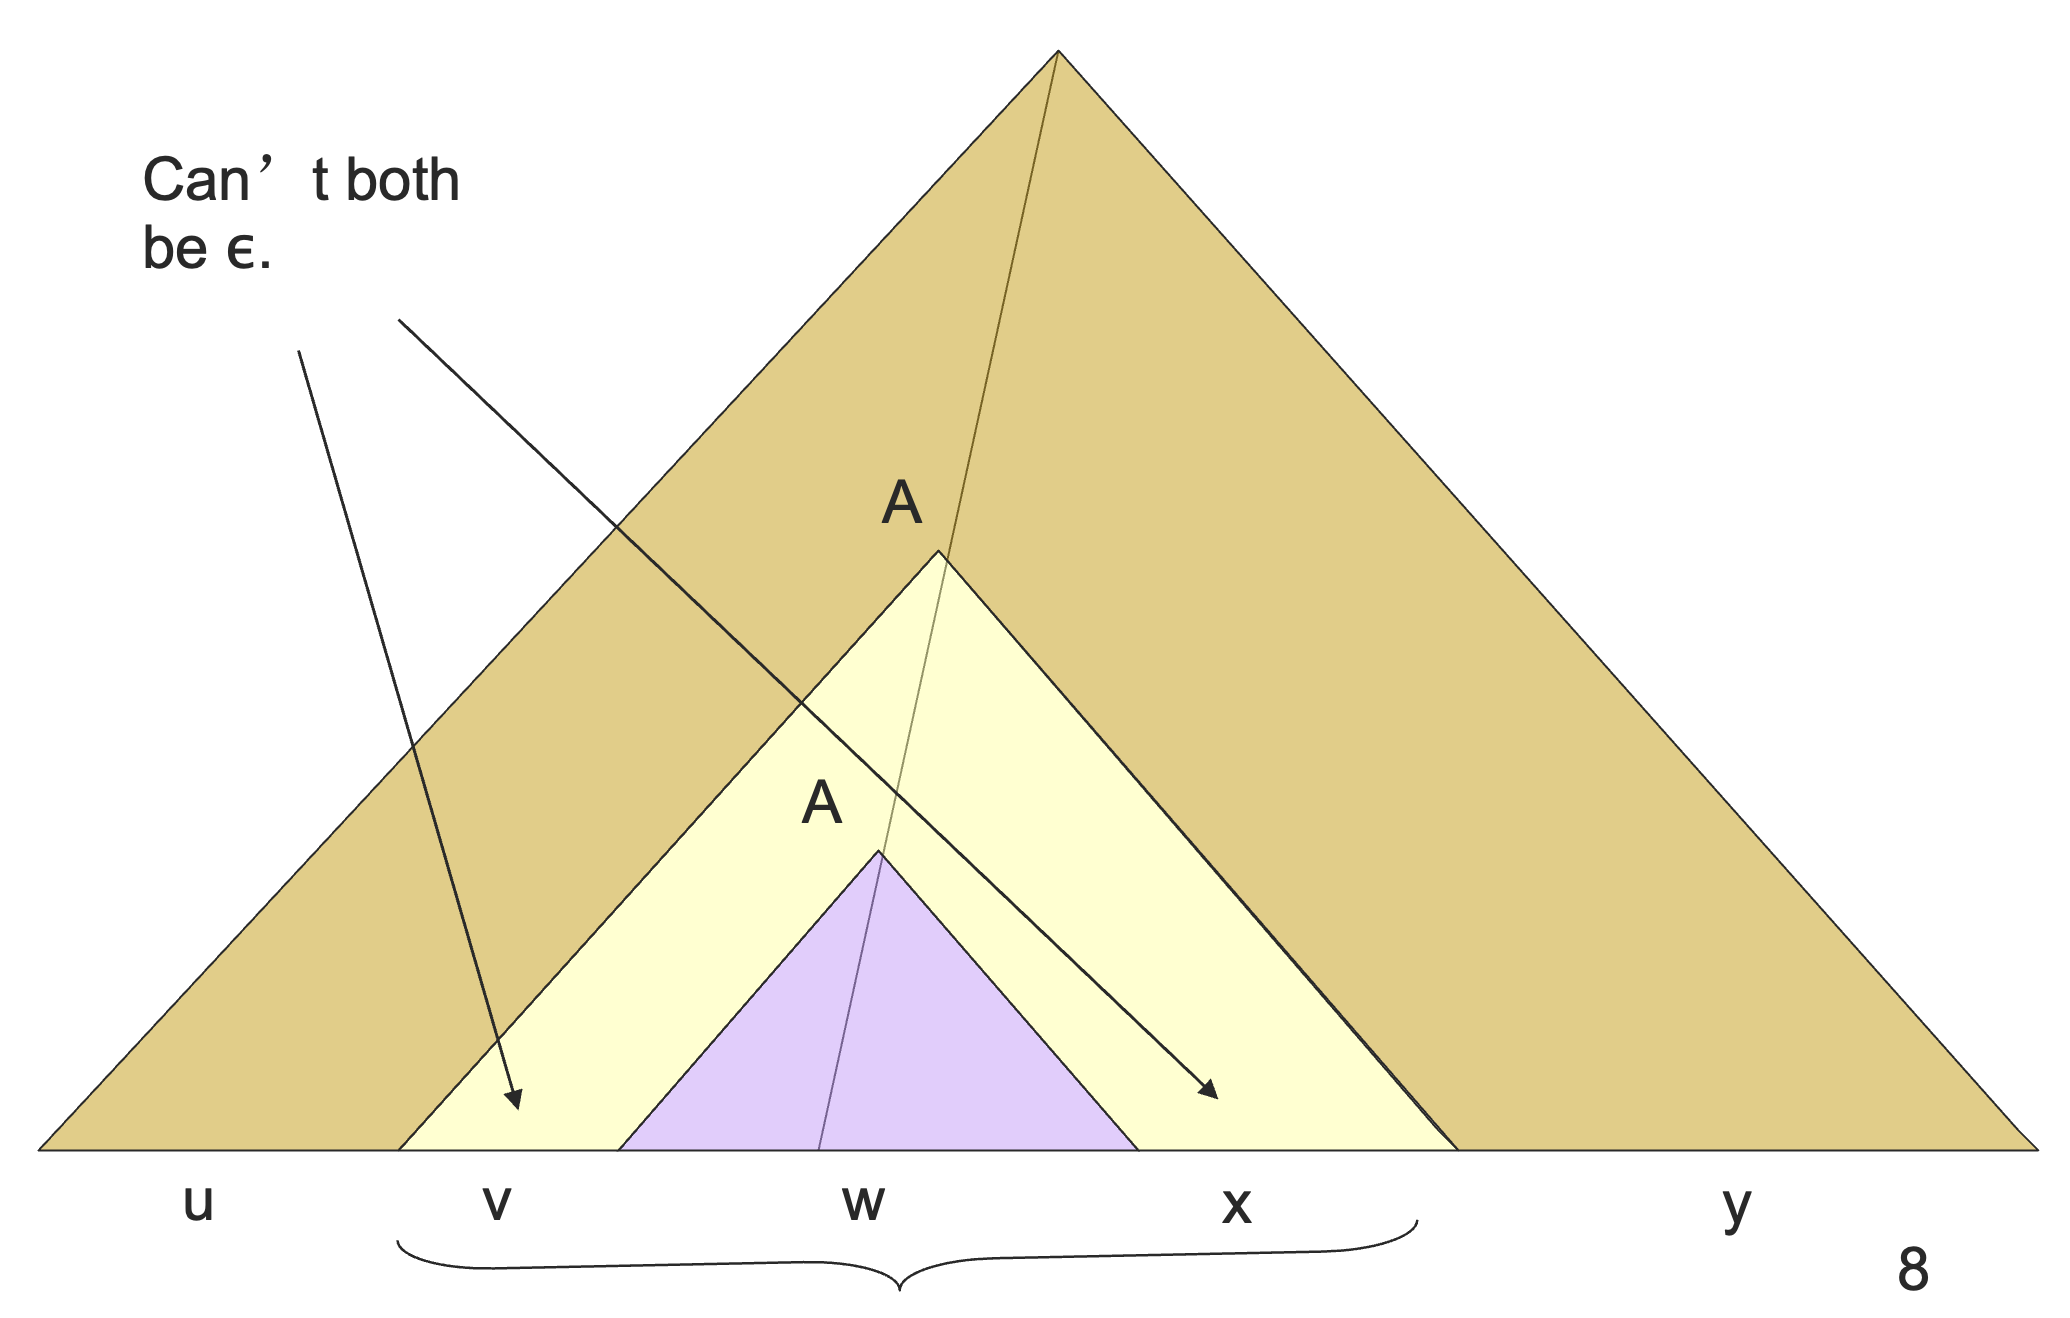
CFL的闭包性质/判定性质
闭包性质
差集不封闭,交集不封闭,补集不封闭
判定性质
- 是否为空
- 判断字符串是否属于CFL
- 是否有限
上下文无关语言不一定是无限的。CFL 的泵引理只对“足够长”的字符串成立,如果语言本身是有限的(即不存在长度大于等于泵引理常数 \(n\) 的字符串),则泵引理条件永远不会触发。有限语言总是上下文无关的,但不是所有上下文无关语言都是无限的。
图灵机
定义
\[T = (Q, \Sigma, \Gamma, \delta, q_0, B, F)\]即时描述
即时描述是图灵机在某一时刻的状态表示,通常表示一个字符串\(\alpha q \beta\),其中:
- \(\alpha \beta\)表示带上的符号串(最左非空到最右非空)
- \(q \in Q\):当前状态,放置在当前扫描的字符的左侧,如果是扫描空白符号:在最右侧可以不写,在左侧则需要写出\(qB\alpha\beta\)
等价性
L(M) = L(H): 通过终止状态定义语言的图灵机和通过停机接受的图灵机等价
构造:
- L(M) \(\Rightarrow\) L(H)
- 删除掉所有中止状态的转移,将所有终止状态的转移改为停机接受
- 为了避免意外停机,对于所有非终止状态且未定义的转移,添加向永远向右移动的转移
- L(H) \(\Rightarrow\) L(M): 将所有停机接受的转移改为终止状态的转移,并添加唯一一个终止状态,将所有未定义的转移转移向这个唯一中止态
编程技巧
- 多带
- 多道
- 标记,在一个带上标记不同的符号,在另一个带上进行操作
判定性和复杂度
规约
P,NP, NP-complete, NP-hard
- P:多项式时间可解的问题集合
- NP:非确定性多项式时间可解的问题集合
- NP-Hard:所有NP问题都可以规约到它(NP \(\leq\) NP-Hard)
- NP-Complete:NP-Hard & NP
单词对照
| 缩写/术语 | 中文释义 | 英文全称/解释 |
|---|---|---|
| DFA | 确定性有限自动机 | Deterministic Finite Automaton |
| NFA | 非确定性有限自动机 | Nondeterministic Finite Automaton |
| NFA-ε | 非确定性有限自动机(允许空转移) | NFA with ε-moves |
| CFG | 上下文无关文法 | Context-Free Grammar |
| CFL | 上下文无关语言 | Context-Free Language |
| PDA | 下推自动机 | Pushdown Automaton |
| NPDA | 非确定性下推自动机 | Nondeterministic Pushdown Automaton |
| RE | 正则表达式 | Regular Expression |
| ID | 即时描述(格局) | Instantaneous Description |
| RE | 递归可枚举语言 | Recursively Enumerable Language |
| Recursive Language | 递归语言 | Recursive Language |
| Reduction | 规约 | Reduction |
总结
- 泵引理证明: 对于字符串的长度进行归纳
- 自动机/文法类的证明: 对步骤数进行归纳
- 图灵机/复杂度类的证明: 规约(已知A到未知B规约(\(A \leq B\)))